06310 Prozess- und Datenanalyse als Grundlage für sichere KI
|
Sichere KI beginnt nicht beim Modell, sondern bei Daten und Prozessen. Dieser Beitrag zeigt, warum Datenqualität, Dateninventar, Datenflussanalyse und Data Governance die Grundlage für rechtskonforme und belastbare KI-Systeme sind. Er erläutert, wie Unternehmen Prozesse auf KI-Eignung prüfen, Automatisierungspotenziale erkennen und Anforderungen aus AI Act, DSGVO und ISO/IEC 42001 frühzeitig berücksichtigen. Mit Praxisempfehlungen zu Datenklassifikation, Monitoring, DSFA und Compliance-by-Design für Verantwortliche in Datenschutz, IT, Prozessmanagement und KI-Governance – kompakt, praxisnah und mit konkreten Handlungsempfehlungen. Arbeitshilfen: von: |
Schnelleinstieg ins Thema – Drei wichtige Fragen, auf die dieser Beitrag eine Antwort gibt:
Frage 1: Wie kann ein Unternehmen schnell prüfen, ob die eigenen Daten überhaupt für KI geeignet sind?
Antwort: Der Beitrag empfiehlt einen einfachen Datenqualitäts-Check mit sechs Kriterien: Genauigkeit, Vollständigkeit, Konsistenz, Aktualität, Relevanz und Repräsentativität. Für KMU ist ein kompaktes Ampelsystem pro Datenbestand ein guter Start, um Risiken früh zu erkennen und ungeeignete KI-Projekte zu stoppen. Mehr dazu s. Abschnitt 6 „Datenqualität bewerten und verbessern”.
Frage 2: Wie können Unternehmen Data Governance für KI mit überschaubarem Aufwand aufbauen?
Antwort: Der Beitrag empfiehlt für KMU einen pragmatischen Einstieg mit wenigen kritischen Datenbeständen, klar benannten Verantwortlichen und einer einfachen Qualitätsampel. So lassen sich Datenzugriffe, Qualität, Freigaben und Compliance schrittweise strukturieren, ohne sofort eine große Governance-Organisation aufzubauen. Mehr dazu s. Abschnitt 7 „Data Governance für KI: Rollen, Prozesse und Werkzeuge”.
Frage 3: Welche konkreten Vorlagen und Werkzeuge helfen Unternehmen beim Start mit sicherer KI?
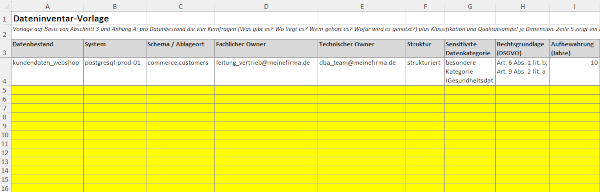
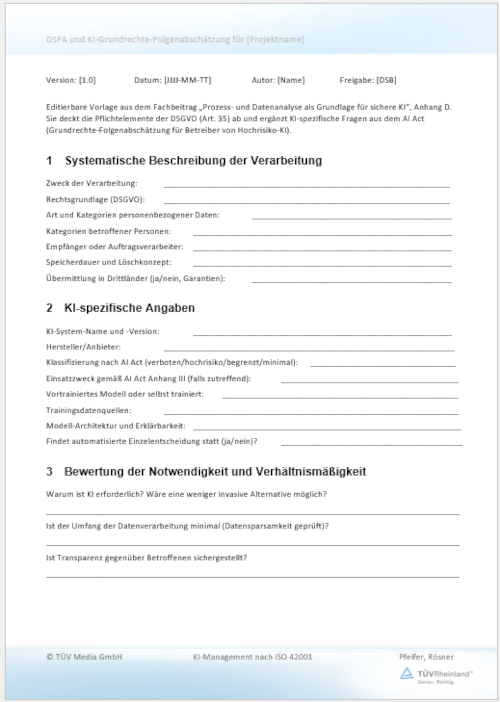
Antwort: Die Anhänge liefern direkt nutzbare Hilfen für die Praxis, darunter Werkzeuge für Dateninventar und Lineage, Beispiele für Process Mining, Datenqualitätsprüfungen mit Great Expectations sowie ein Template für DSFA und KI-Grundrechte-Folgenabschätzung. Damit können Unternehmen viele Anforderungen schneller, strukturierter und nachvollziehbarer umsetzen. [1] Mehr dazu s. Abschnitt 9.
1 Überblick
Datenqualität entscheidet
Die Datenqualität entscheidet, ob KI zum Produktivitäts- oder Risikoverstärker wird. Datenprobleme pflanzen sich entlang der KI-Pipeline nicht nur fort, sie verstärken sich („Data Cascades”). Sechs Dimensionen machen Datenqualität messbar: Accuracy, Completeness, Consistency, Timeliness, Relevance und Representativeness. Die Kosten schlechter Daten reichen von direkter Nacharbeit über Folgeschäden bis zu Sanktionen und Reputationsverlust.
Die Datenqualität entscheidet, ob KI zum Produktivitäts- oder Risikoverstärker wird. Datenprobleme pflanzen sich entlang der KI-Pipeline nicht nur fort, sie verstärken sich („Data Cascades”). Sechs Dimensionen machen Datenqualität messbar: Accuracy, Completeness, Consistency, Timeliness, Relevance und Representativeness. Die Kosten schlechter Daten reichen von direkter Nacharbeit über Folgeschäden bis zu Sanktionen und Reputationsverlust.
KI-Risiken vorbeugen
Bei der Frage, wo im Unternehmen das Budget hinfließt, sind einige Kategorien direkt sichtbar. Hierzu zählen unter anderem SaaS-Dienste und Plattformen, Schulungen sowie KI-Modelle mit ihren Laufzeitkosten. Sie alle sind sichtbar und lassen sich einfach budgetieren. Die Datenarbeit, von der der Erfolg eigener KI-Modelle abhängt, bleibt oft unsichtbar. Wird diese Arbeit vernachlässigt, entstehen oft teure Folgekosten: Halluzinationen aus lückenhaften Quellen, diskriminierende Empfehlungen aus unausgewogenen Trainingsdaten, regulatorisch problematische Verarbeitungen aus unklarer Herkunft.
Bei der Frage, wo im Unternehmen das Budget hinfließt, sind einige Kategorien direkt sichtbar. Hierzu zählen unter anderem SaaS-Dienste und Plattformen, Schulungen sowie KI-Modelle mit ihren Laufzeitkosten. Sie alle sind sichtbar und lassen sich einfach budgetieren. Die Datenarbeit, von der der Erfolg eigener KI-Modelle abhängt, bleibt oft unsichtbar. Wird diese Arbeit vernachlässigt, entstehen oft teure Folgekosten: Halluzinationen aus lückenhaften Quellen, diskriminierende Empfehlungen aus unausgewogenen Trainingsdaten, regulatorisch problematische Verarbeitungen aus unklarer Herkunft.
KI sicher planen
Dieser Beitrag beschreibt, wie Unternehmen ihre Datenlandschaften systematisch erschließen, Prozesse auf Automatisierungspotenzial prüfen und Datenqualität als Dauerthema etablieren, mit den Anforderungen des AI Act, der DSGVO und der ISO/IEC 42001 als Entwurfskriterien, nicht als nachträgliche Korrektur. Es richtet sich an KI-Verantwortliche, Datenschutzbeauftragte, Data Owner, Prozessmanager und IT-Leiter, die die Grundlage schaffen, auf der die KI später wachsen soll.
Dieser Beitrag beschreibt, wie Unternehmen ihre Datenlandschaften systematisch erschließen, Prozesse auf Automatisierungspotenzial prüfen und Datenqualität als Dauerthema etablieren, mit den Anforderungen des AI Act, der DSGVO und der ISO/IEC 42001 als Entwurfskriterien, nicht als nachträgliche Korrektur. Es richtet sich an KI-Verantwortliche, Datenschutzbeauftragte, Data Owner, Prozessmanager und IT-Leiter, die die Grundlage schaffen, auf der die KI später wachsen soll.
Compliance als Entwurfskriterium
So wird ein systematischer Weg zur belastbaren Datengrundlage aufgezeigt: Dateninventar und Klassifizierung, Datenflussanalyse mit Lineage und Provenance, Prozessanalyse in drei Stufen, kontinuierliches Datenqualitätsmanagement und Data Governance mit klaren Rollen. AI Act, DSGVO und ISO/IEC 42001 wirken dabei als Entwurfskriterien von Anfang an – Compliance-by-Design statt nachträglicher Korrektur.
So wird ein systematischer Weg zur belastbaren Datengrundlage aufgezeigt: Dateninventar und Klassifizierung, Datenflussanalyse mit Lineage und Provenance, Prozessanalyse in drei Stufen, kontinuierliches Datenqualitätsmanagement und Data Governance mit klaren Rollen. AI Act, DSGVO und ISO/IEC 42001 wirken dabei als Entwurfskriterien von Anfang an – Compliance-by-Design statt nachträglicher Korrektur.
Die Grundlage für diesen Fachbeitrag wurde unter Nutzung des KI-Modells Claude Opus 4.8 von Antrophic erstellt. Eine umfassende Überarbeitung und Prüfung erfolgte durch die Autoren, den Herausgeber und die Redaktion.
2 Warum schlechte Daten schlechte KI erzeugen
Datenqualität ist Managementthema
Datenqualität ist im KI-Kontext eine der wichtigsten Kennzahlen und verdient nicht nur von technischer Seite besondere Aufmerksamkeit, sondern auch durch die Managementebene. Wer auf eine schwache Datenbasis aufsetzt, baut ein System, das schlechte Ergebnisse dauerhaft und in hoher Frequenz produziert.
Datenqualität ist im KI-Kontext eine der wichtigsten Kennzahlen und verdient nicht nur von technischer Seite besondere Aufmerksamkeit, sondern auch durch die Managementebene. Wer auf eine schwache Datenbasis aufsetzt, baut ein System, das schlechte Ergebnisse dauerhaft und in hoher Frequenz produziert.
Data Cascades
Fachlich hat sich dafür der Begriff der „Data Cascades" eingebürgert. Er bedeutet, dass Datenprobleme, sich entlang der KI-Pipeline nicht nur fortpflanzen, sondern verstärken. Empirische Befragungen von Praktikern in risikoreichen KI-Anwendungen zeigen, dass eine deutliche Mehrheit der untersuchten KI-Projekte von mindestens einer solchen Kaskade betroffen war. Der Grund hierfür liegt in den Organisationen, denn Datenarbeit bekommt in vielen Organisationen nicht den notwendigen Fokus und Rahmen. Dieser Schritt wird gerne auf das Minimum reduziert und von der Modellarbeit überschattet, was zu teuren Folgen führen kann [1].
Fachlich hat sich dafür der Begriff der „Data Cascades" eingebürgert. Er bedeutet, dass Datenprobleme, sich entlang der KI-Pipeline nicht nur fortpflanzen, sondern verstärken. Empirische Befragungen von Praktikern in risikoreichen KI-Anwendungen zeigen, dass eine deutliche Mehrheit der untersuchten KI-Projekte von mindestens einer solchen Kaskade betroffen war. Der Grund hierfür liegt in den Organisationen, denn Datenarbeit bekommt in vielen Organisationen nicht den notwendigen Fokus und Rahmen. Dieser Schritt wird gerne auf das Minimum reduziert und von der Modellarbeit überschattet, was zu teuren Folgen führen kann [1].
„Wer KI auf eine schwache Datenbasis aufsetzt, baut ein System, das schlechte Ergebnisse dauerhaft und in hoher Frequenz produziert.”
Sechs Dimensionen machen Qualität messbar
Diese Folgen zeigen sich oft erst im laufenden KI-Betrieb und oft nur dann, wenn ein Bewusstsein dafür besteht. Damit diese früh erkennbar werden, lässt sich Datenqualität an sechs etablierten Dimensionen festmachen (s. Tabelle 1). Diese Dimensionen wirken abstrakt, werden aber an konkreten KI-Fehlerbildern greifbar [2]:
Diese Folgen zeigen sich oft erst im laufenden KI-Betrieb und oft nur dann, wenn ein Bewusstsein dafür besteht. Damit diese früh erkennbar werden, lässt sich Datenqualität an sechs etablierten Dimensionen festmachen (s. Tabelle 1). Diese Dimensionen wirken abstrakt, werden aber an konkreten KI-Fehlerbildern greifbar [2]:
Tabelle 1: Datenqualitätsdimensionen mit KI-spezifischen Fehlerbeispielen
Dimension | KI-spezifisches Fehlerbeispiel |
|---|---|
Accuracy (Genauigkeit) | Ein Predictive-Maintenance-Modell lernt auf manuell erfassten Sensorwerten mit unentdeckten Eingabefehlern. Das Modell verschiebt seine Vorhersagen systematisch in dieselbe Richtung. |
Completeness (Vollständigkeit) | Chatbot-Wissensbasis enthält nur die ersten 3 von 7 Produktreihen; Kundenanfragen zu den fehlenden Reihen erzeugen Halluzinationen statt „Ich weiß es nicht”. |
Consistency (Konsistenz) | Adressdaten im CRM und im ERP weichen bei 12 % der Kunden ab. Werden diese Quellen beim Feature Engineering ungeprüft zusammengeführt, fließen widersprüchliche Werte in die Trainings- und Eingabedaten ein. Das Cross-Sell-Modell verarbeitet diese unbemerkt und liefert dadurch verschlechterte, instabile Empfehlungen. |
Timeliness (Aktualität) | Preisempfehlungsmodell nutzt Marktpreise mit drei Wochen Latenz; in volatilen Phasen liegen die Empfehlungen systematisch unter Marktniveau. |
Relevance (Relevanz) | Klassifikationsmodell für Service-Tickets wurde auf alten Ticketkategorien trainiert, die seit zwei Reorganisationen nicht mehr existieren. |
Representativeness (Repräsentativität) | Kundendaten aus Deutschland trainieren ein Bonitätsmodell, das später in Norwegen eingesetzt wird. Lokale Zahlungsverhalten und gesetzliche Spielräume sind nicht abgebildet. |
Der AI Act schenkt diesen Dimensionen besondere Bedeutung. Für Hochrisiko-KI stellt er hohe Anforderungen an Trainings-, Validierungs- und Testdaten, insbesondere hinsichtlich Relevanz, Repräsentativität, Vollständigkeit und Fehlerarmut im Rahmen geeigneter Daten-Governance. Diese Anforderung richtet sich in erster Linie an Anbieter und ist für sie rechtlich bindend. Ihre Nichterfüllung kann Konformitätsbewertung und Marktzugang gefährden. Betreiber müssen im Rahmen ihrer Rolle, für eine sachgerechte Datenbasis im eigenen Verantwortungsbereich zu sorgen [3].