07110 Warum klassisches Projektmanagement bei KI scheitert
|
KI-Projekte sind keine Softwareprojekte mit Datenbeilage, sondern Lernprojekte mit Ungewissheit. Genau daran scheitern viele Vorhaben in Unternehmen: Anforderungen werden zu früh fixiert, Datenprobleme unterschätzt und der Betrieb nach dem Go-live nicht mitgedacht. Der Beitrag analysiert die typischen Fehler des klassischen Projektmanagements und zeigt praxistaugliche Alternativen für erfolgreiche KI-Projektführung – von Data Readiness über CRISP- DM bis zu MLOps, Review-Logiken und klaren Abbruchkriterien für Modellansätze. Ein kompakter Praxisleitfaden mit sieben Grundregeln hilft, KI-Projekte realistisch, wirksam und wirtschaftlich zu steuern. Arbeitshilfen: von: |
Schnelleinstieg ins Thema – Drei wichtige Fragen, auf die dieser Beitrag eine Antwort gibt:
Frage 1: Warum scheitern viele KI-Projekte, obwohl Planung, Budget und Dienstleister zunächst überzeugend wirken?
Antwort: Weil KI-Projekte keine klassischen Softwareprojekte sind, sondern Lernprojekte mit Unsicherheit. Feste Anforderungen, starre Zeitpläne und binäre Abnahmekriterien passen oft nicht zu Datenqualität, Modelltraining und iterativer Optimierung. Mehr dazu s. Abschnitt 2.2 „Die Anatomie des klassischen KI-Projektversagens” und s. Abschnitt 3 „Warum klassisches PM bei KI strukturell scheitert”.
Frage 2: Was sollten Unternehmen vor dem Start eines KI-Projekts unbedingt prüfen, um teure Fehlentwicklungen zu vermeiden?
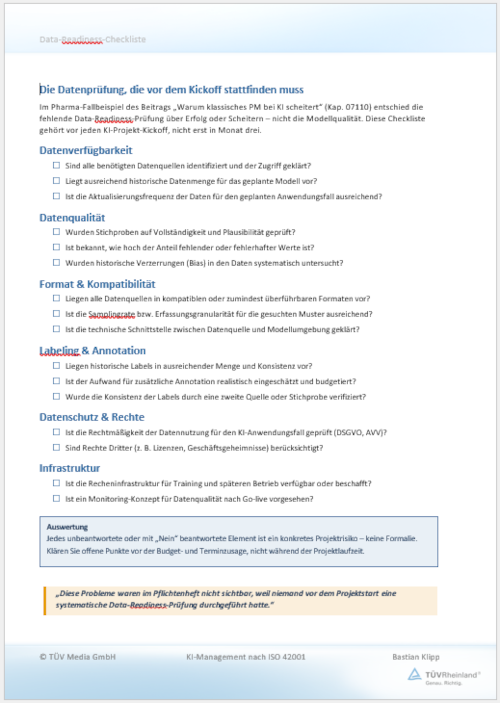
Antwort: Am wichtigsten ist eine saubere Data-Readiness-Analyse: Sind genug Daten vorhanden, sind sie vollständig, konsistent und für das gewünschte Modell überhaupt nutzbar? Der Beitrag empfiehlt, dafür schon vor dem offiziellen Projektstart vier bis acht Wochen einzuplanen. Mehr dazu s. Abschnitt 4.3 „Unterschied 3 – Technische Risiken vs. Data-Readiness-Risiken” sowie s. Abschnitt 6.1.1 „Grundregel 1”
Frage 3: Warum sollten Geschäftsverantwortliche in KI-Projekten regelmäßig die Modellergebnisse mitbewerten?
Antwort: Weil die Frage, ob eine Modellleistung von zum Beispiel 79 Prozent ausreicht, keine rein technische, sondern eine geschäftliche Entscheidung ist. Erst wenn Kennzahlen wie Precision oder Recall in Nutzen, Kosten und Risiken übersetzt werden, lässt sich der praktische Wert des KI-Systems realistisch beurteilen. Mehr dazu s. Abschnitt 6.1.5 „Grundregel 5” und s. Abschnitt 6.2.4 „Fallstrick: Die fehlende Stakeholder-Übersetzung”.
1 Einordnung und Kernaussagen
Scheitern aufgrund falschen Vorgehens
KI-Projekte scheitern häufiger als nötig und der häufigste Grund ist, neben mangelnden Daten oder einem unzureichenden Budget, insbesondere das falsche Vorgehensmodell. Unternehmen wenden auf KI-Projekte dieselben Steuerungslogiken an, die sich in klassischen IT- und Softwareprojekten bewährt haben: feste Anforderungen, lineare Phasen, klar definierte Meilensteine, binäre Erfolgs- oder Misserfolgskriterien. Diese Logik ist für KI-Projekte strukturell ungeeignet.
KI-Projekte scheitern häufiger als nötig und der häufigste Grund ist, neben mangelnden Daten oder einem unzureichenden Budget, insbesondere das falsche Vorgehensmodell. Unternehmen wenden auf KI-Projekte dieselben Steuerungslogiken an, die sich in klassischen IT- und Softwareprojekten bewährt haben: feste Anforderungen, lineare Phasen, klar definierte Meilensteine, binäre Erfolgs- oder Misserfolgskriterien. Diese Logik ist für KI-Projekte strukturell ungeeignet.
KI-Projekte sind keine Softwareprojekte
KI-Projekte sind keine Softwareprojekte mit Datenbeilage. Sie sind permanente Lernprojekte mit eingebauter stetiger Ungewissheit. Die Anforderungen können nicht vollständig vorab definiert werden, weil das Modellverhalten erst durch Experimente sichtbar wird. Der Zeitplan kann nicht garantiert werden, weil Datenqualität und Modellperformance iterativ erschlossen werden müssen. Und der Abschluss kann nicht sauber definiert werden, weil ein KI-Modell nach dem Go-live kontinuierlich betreut, überwacht und weiterentwickelt werden muss.
KI-Projekte sind keine Softwareprojekte mit Datenbeilage. Sie sind permanente Lernprojekte mit eingebauter stetiger Ungewissheit. Die Anforderungen können nicht vollständig vorab definiert werden, weil das Modellverhalten erst durch Experimente sichtbar wird. Der Zeitplan kann nicht garantiert werden, weil Datenqualität und Modellperformance iterativ erschlossen werden müssen. Und der Abschluss kann nicht sauber definiert werden, weil ein KI-Modell nach dem Go-live kontinuierlich betreut, überwacht und weiterentwickelt werden muss.
Vorgehensmodelle die Funktionieren
Im Folgenden werden die strukturellen Ursachen des klassischen Projektmanagementversagens im KI-Kontext analysiert und es wird gezeigt, welche Vorgehensmodelle wirklich funktionieren:
Im Folgenden werden die strukturellen Ursachen des klassischen Projektmanagementversagens im KI-Kontext analysiert und es wird gezeigt, welche Vorgehensmodelle wirklich funktionieren:
| • | das iterative Experimentiermodell, |
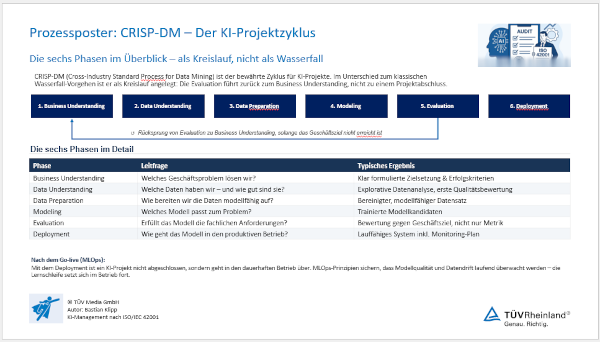
| • | CRISP- DM als bewährter KI-Projektzyklus, |
| • | MLOps-Prinzipien für den Modelleinsatz, |
| • | sowie agile Prinzipien, die sich sinnvoll auf KI-Projekte übertragen lassen. |
Praxisleitfaden
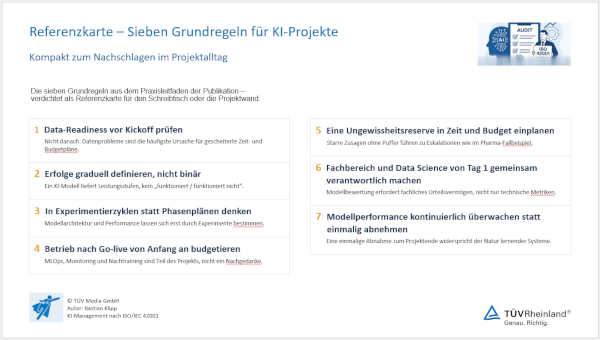
Den Abschluss bildet ein konkreter Praxisleitfaden mit sieben Grundregeln und den typischen Fallstricken, die erfolgreiche KI-Projekte von gescheiterten unterscheiden.
Den Abschluss bildet ein konkreter Praxisleitfaden mit sieben Grundregeln und den typischen Fallstricken, die erfolgreiche KI-Projekte von gescheiterten unterscheiden.
Das Ziel dieses Beitrags ist eindeutig:
Wer KI-Projekte führt, soll danach konkret wissen, was er anders machen muss. Nicht irgendwann, sondern beim nächsten Projektstart.
2.1 Wenn alles stimmt und trotzdem nichts funktioniert
Ein Pharmaunternehmen, gut aufgestellt, mit einer erfahrenen IT-Abteilung und einem bewährten Framework für Projektmanagement (PM).
Das Ziel:
Ein KI-System, das Anomalien in Produktionsdaten erkennt und so Qualitätsprobleme frühzeitig identifiziert, bevor sie die Abfüllanlage erreichen. Das Versprechen des Dienstleisters: ein funktionstüchtiges System in neun Monaten, Budget 680.000 Euro.
Ein KI-System, das Anomalien in Produktionsdaten erkennt und so Qualitätsprobleme frühzeitig identifiziert, bevor sie die Abfüllanlage erreichen. Das Versprechen des Dienstleisters: ein funktionstüchtiges System in neun Monaten, Budget 680.000 Euro.
Die Planung war solide:
Ein detailliertes Lasten- und Pflichtenheft wurde erstellt. Die Anforderungen wurden in einem dreitägigen Workshop zwischen IT, Produktion und Qualitätssicherung definiert. Phasen, Meilensteine und Abnahmekriterien wurden schriftlich fixiert.
Ein detailliertes Lasten- und Pflichtenheft wurde erstellt. Die Anforderungen wurden in einem dreitägigen Workshop zwischen IT, Produktion und Qualitätssicherung definiert. Phasen, Meilensteine und Abnahmekriterien wurden schriftlich fixiert.
Der Projektplan sah vor:
Datenbeschaffung im ersten Quartal, Modellentwicklung im zweiten, Testing und Validierung im dritten, Go-live zum Jahresende.
Datenbeschaffung im ersten Quartal, Modellentwicklung im zweiten, Testing und Validierung im dritten, Go-live zum Jahresende.
Monat drei:
Die Dateningenieure, bestehend aus Data Engineer und Data Scientist stellen fest, dass die Sensordaten aus der Anlage in drei unterschiedlichen, teilweise inkompatiblen Formaten vorliegen. Die historischen Anomalie-Labels, auf denen das Modell durch die ML Engineers trainiert werden soll, sind in 40 Prozent der Fälle inkonsistent verzeichnet. Und die Samplingrate (Abtastrate) der Sensoren ist zu niedrig, um bestimmte Anomaliemuster überhaupt zu erfassen. Diese Probleme waren im Pflichtenheft nicht sichtbar, weil niemand vor dem Projektstart eine systematische Data-Readiness-Prüfung durchgeführt hatte.
Die Dateningenieure, bestehend aus Data Engineer und Data Scientist stellen fest, dass die Sensordaten aus der Anlage in drei unterschiedlichen, teilweise inkompatiblen Formaten vorliegen. Die historischen Anomalie-Labels, auf denen das Modell durch die ML Engineers trainiert werden soll, sind in 40 Prozent der Fälle inkonsistent verzeichnet. Und die Samplingrate (Abtastrate) der Sensoren ist zu niedrig, um bestimmte Anomaliemuster überhaupt zu erfassen. Diese Probleme waren im Pflichtenheft nicht sichtbar, weil niemand vor dem Projektstart eine systematische Data-Readiness-Prüfung durchgeführt hatte.
Monat fünf:
Das erste Modell ist trainiert. Die Erkennungsrate für Anomalien liegt bei 61 Prozent. Der Zielwert im Pflichtenheft: 85 Prozent. Der Dienstleister optimiert weiter. Monat sieben: 74 Prozent. Noch immer unter Ziel. Die Geschäftsführung fragt nach dem ursprünglichen Go-live-Termin. Der Projektleiter schreibt den ersten Statusbericht mit rotem Ampelindikator.
Das erste Modell ist trainiert. Die Erkennungsrate für Anomalien liegt bei 61 Prozent. Der Zielwert im Pflichtenheft: 85 Prozent. Der Dienstleister optimiert weiter. Monat sieben: 74 Prozent. Noch immer unter Ziel. Die Geschäftsführung fragt nach dem ursprünglichen Go-live-Termin. Der Projektleiter schreibt den ersten Statusbericht mit rotem Ampelindikator.
Monat neun, geplanter Projektabschluss:
Das System erreicht 79 Prozent Erkennungsrate. Die Abnahme scheitert an den vertraglich festgelegten 85 Prozent. Der Dienstleister fordert Nachtragsbudget. Das Pharmaunternehmen beauftragt externe Gutachter. Zwei Jahre nach Projektstart wird das Projekt offiziell als gescheitert eingestuft. Gesamtschaden: 1,1 Millionen Euro.
Das System erreicht 79 Prozent Erkennungsrate. Die Abnahme scheitert an den vertraglich festgelegten 85 Prozent. Der Dienstleister fordert Nachtragsbudget. Das Pharmaunternehmen beauftragt externe Gutachter. Zwei Jahre nach Projektstart wird das Projekt offiziell als gescheitert eingestuft. Gesamtschaden: 1,1 Millionen Euro.
Ergebnis:
Kein produktives KI-System.
Kein produktives KI-System.
„Ein KI-Projekt ist kein Softwareprojekt mit Datenbeilage.Es ist ein Lernprojekt mit Ungewissheitsgarantie.Wer es nach Pflichtenheft führt, plant zuverlässig am Ergebnis vorbei.”
Was ist schiefgelaufen? Weder die Technologie noch der Dienstleister oder das Pharmaunternehmen selbst war das Problem.
Das Problem war die Projektführungslogik: klassisches Wasserfall-Projektmanagement, angewendet auf ein Problem, das strukturell nicht mit Wasserfall lösbar ist.
2.2 Die Anatomie des klassischen KI-Projektversagens
Bis zu 95 % der KI-Pilot-Projekte scheitern
Das Pharmaprojekt ist kein Einzelfall. Studien aus dem Bereich KI-Projektmanagement zeigen konsistent, dass ein sehr großer Teil der KI-Projekte, insbesondere die wichtigen KI-Pilot-Projekte, ihre ursprünglichen Ziele verfehlt; aktuelle Untersuchungen berichten sogar, dass etwa 95 Prozent der Vorhaben keinen substanziellen wirtschaftlichen Nutzen erzielen. [1]
Das Pharmaprojekt ist kein Einzelfall. Studien aus dem Bereich KI-Projektmanagement zeigen konsistent, dass ein sehr großer Teil der KI-Projekte, insbesondere die wichtigen KI-Pilot-Projekte, ihre ursprünglichen Ziele verfehlt; aktuelle Untersuchungen berichten sogar, dass etwa 95 Prozent der Vorhaben keinen substanziellen wirtschaftlichen Nutzen erzielen. [1]
Hauptursachen
Und die Hauptursachen sind überwiegend keine technischen, sondern methodische. Drei Muster wiederholen sich besonders häufig.
Und die Hauptursachen sind überwiegend keine technischen, sondern methodische. Drei Muster wiederholen sich besonders häufig.
| • | Muster 1: Überambitionierte Anforderungsdefinition zu Beginn:Klassisches Projektmanagement (PM) verlangt vollständige Anforderungsdefinition vor Projektstart. Bei KI-Projekten ist das strukturell unmöglich: Welche Modellarchitektur geeignet ist, welche Datenmengen benötigt werden, welche Performance realistisch erreichbar ist, all das kann erst durch Experimente bestimmt werden. Wer trotzdem starre Zielwerte ins Pflichtenheft schreibt, schreibt Fiktion. |
| • | Muster 2: Unterschätzung der Datenvorbereitung:In klassischen IT-Projekten ist Datenübertragung und -migration eine planbare, wenn auch aufwändige Phase. In KI-Projekten ist Datenqualität die zentrale Unsicherheitsvariable. Fehlende Labels, inkonsistente Formate, unzureichende Samplingraten, historische Verzerrungen in den Daten, diese Probleme sind nicht vorhersehbar ohne explizite Data-Readiness-Analyse. Und sie können ein gesamtes Projektzeitplan invalidieren. |
| • | Muster 3: Fehlende Planung für den Post-Go-live-Betrieb:Klassisches PM endet mit dem Go-live. Das System ist geliefert, abgenommen, übergeben. Für KI-Systeme ist der Go-live der Anfang einer neuen Phase: Modell-Monitoring, Drift-Erkennung, Retraining-Zyklen, Bias-Überwachung. Diese Phase wird in klassisch geführten KI-Projekten regelmäßig weder geplant noch budgetiert und führt daher nach dem Go-live zu einer zweiten Welle von Problemen. |